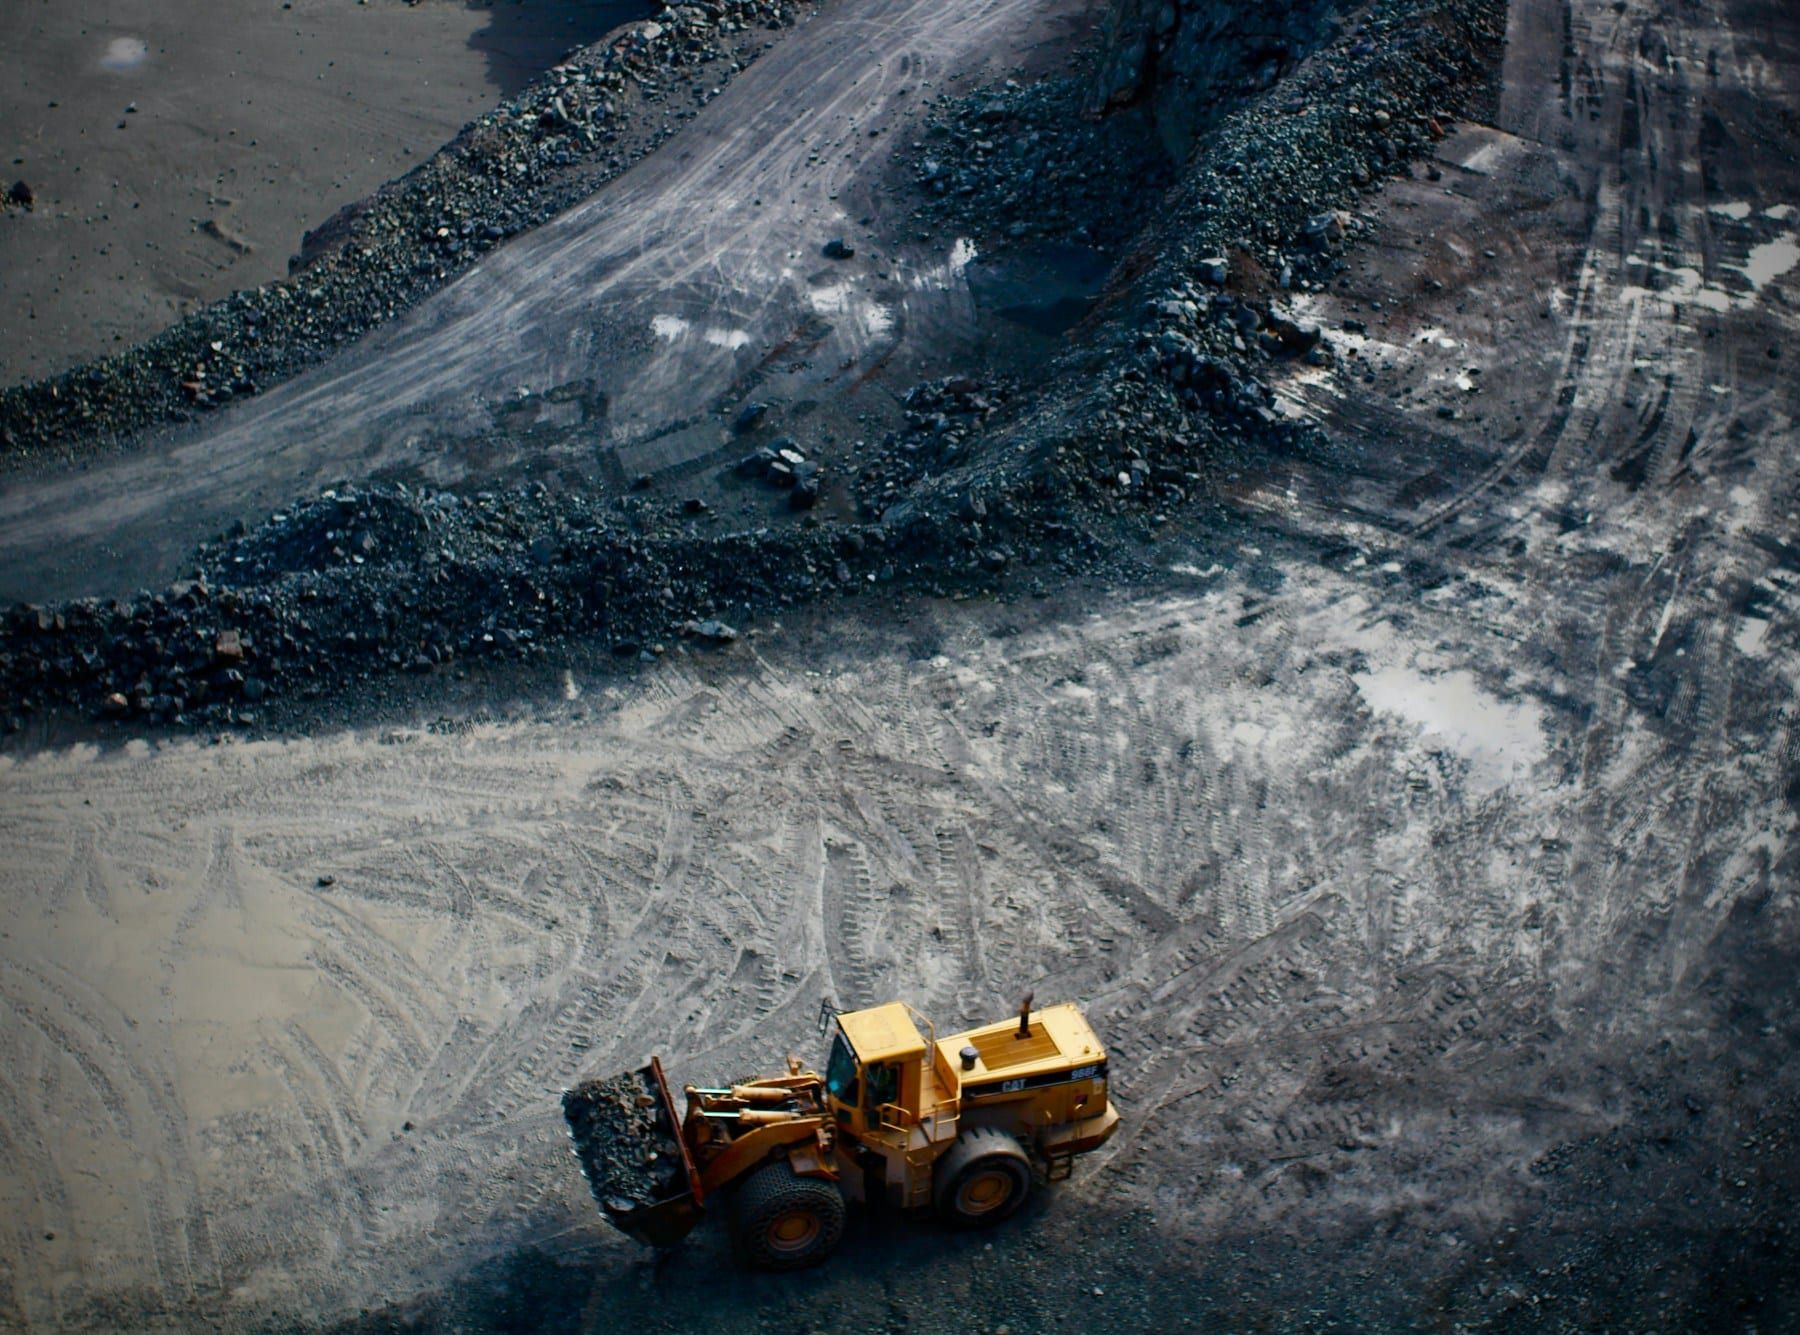
Les pannes imprévues des camions de roulage, convoyeurs, concasseurs et pompes figurent parmi les événements les plus coûteux d’un site minier. Elles arrêtent la production, causent des dommages secondaires et exposent le personnel à des équipements au comportement imprévisible. La maintenance prédictive exploite les données déjà collectées sur site pour anticiper ces pannes.
Partir de la panne, pas de l’algorithme
Tout modèle utile répond à une question précise : quel actif risque le plus de tomber en panne dans les prochaines semaines, et pourquoi ? Avant toute modélisation, nous listons avec les planificateurs de maintenance les modes de défaillance prioritaires, les signes d’alerte que les techniciens surveillent déjà et les décisions qu’un meilleur avertissement changerait. Cette liste détermine les données à collecter.
Les données qui comptent
La plupart des sites disposent déjà de l’essentiel, réparti entre plusieurs systèmes :
- Données d’état : vibrations, températures, analyses d’huile et pressions issues des capteurs et des relevés manuels.
- Données d’exploitation : charge, vitesse, cycle de travail et événements opérateurs issus du système de flotte ou de l’usine.
- Historique de maintenance : ordres de travail, remplacements de composants et codes de défaillance issus de la GMAO.
La norme internationale ISO 17359 sur la surveillance d’état décrit la même logique : identifier les modes de défaillance, choisir les mesures qui les révèlent, fixer des seuils d’alerte, puis agir et réviser.
Construire et valider les modèles
Nous alignons les données par actif et dans le temps, puis entraînons des modèles à reconnaître les signaux qui ont précédé les pannes passées. Deux vérifications comptent plus que le choix du modèle :
- Valider sur un historique que le modèle n’a jamais vu. Si un modèle ne signale pas les pannes de l’an dernier avec les seules données disponibles avant elles, il ne signalera pas celles de l’an prochain.
- Expliquer chaque alerte. Chaque avertissement indique les mesures qui l’ont déclenché, afin qu’un technicien puisse le confirmer sur l’actif avant de planifier l’intervention.
Où vont les résultats
Une alerte n’est utile que si elle parvient à ceux qui planifient le travail. Nous l’intégrons à la GMAO existante sous forme de notification priorisée, preuves à l’appui, plutôt que d’ajouter un tableau de bord de plus.
Démarrer à petite échelle
Un bon pilote porte sur une famille d’actifs disposant d’un historique suffisant, par exemple un parc de pompes ou un ensemble d’entraînements de convoyeurs. Les critères de réussite sont fixés à l’avance, comme le nombre de pannes passées que le modèle aurait détectées et le nombre de fausses alertes acceptable. On n’élargit qu’une fois ces critères atteints.
Source : ISO 17359, Surveillance et diagnostic d’état des machines : lignes directrices générales (iso.org).